資料庫用空白代替 NULL 會發生什麼事?缺值檢查失效,以及數據中台對於「未知」的解法
兩份報表,一份男女加起來 92.38%、一份剛好 100%,加得起來的那份反而錯得最深。當系統禁止 NULL,「不知道」就被存成空白,常見的缺值檢查全都回報「完整」。這篇談空白怎麼騙過檢查,以及數據中台怎麼給「未知」一個名字。
有一份統計報表,分析男生女生的比例,同事 A 算的男生與女生比例合計是 92.38%,同事 B 算出來是 100%,誰是對的?直覺選 B,但 B 一定是對的嗎?
兩份報表,加起來對不上
年底要交一份客戶組成報告,其中一格是「女性客戶佔比」。兩個同事各自撈了一次。
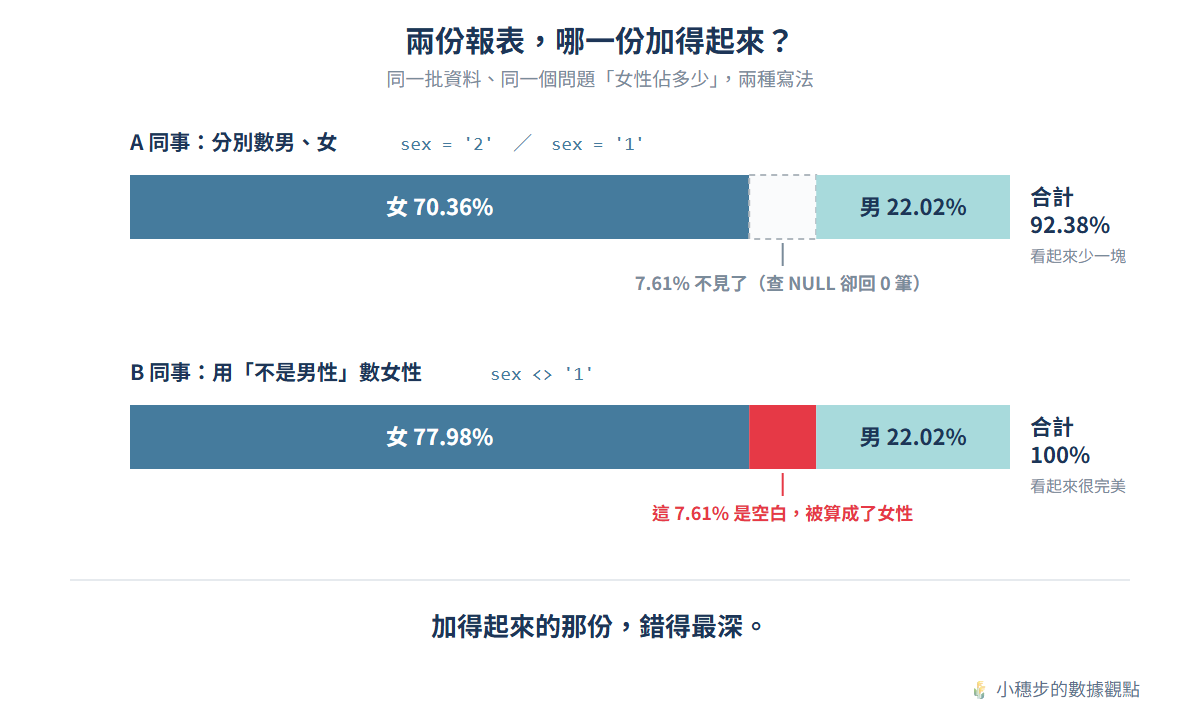
A 同事分別數了男性和女性:
| 性別 | 佔比 |
|---|---|
| 女性(sex = '2') | 70.36% |
| 男性(sex = '1') | 22.02% |
| 合計 | 92.38% |
合計不是 100%。少了 7.6 個百分點。
B 同事的寫法不一樣。他想:不是男性就是女性,所以用「不是男性」來算女性佔比:
SELECT COUNT(*) FROM customer WHERE sex <> '1';算出來女性 77.98%,男性 22.02%,加起來剛好 100%。
兩份報表放在主管桌上。B 那份看起來比較乾淨——它加得起來。
A 同事不甘心。他想到的第一件事很合理:一定是有人沒填性別。於是他去查缺值:
SELECT COUNT(*) FROM customer WHERE sex IS NULL;
-- 回:0
零筆。他又打開資料品質工具,那一欄的完整度寫著:100%。
每一個檢查都說,這個欄位沒有缺值。
但那 7.6% 的人確實存在,而且確實不知道性別。他們只是沒有被記成 NULL——他們被記成了一個空白字元。
更麻煩的是:看起來比較乾淨的 B 那份報表,恰恰是錯得最深的那份。
為什麼會有一套沒有 NULL 的系統
NULL 是資料庫裡表示「這一格沒有值」的專用標記。空白不一樣,空白是一個真的字元,就像你按了一下空白鍵——它是「有值,只是值長那樣」。
這套系統的欄位,幾乎一律設成了 NOT NULL:資料庫不允許這一格是空的。我一開始以為只是幾張表,實際查下去,是全系統的慣例。
一格不准是空的,那「不知道」要填什麼?只好為每一種型別發明一個代表沒有的值。日期欄位填一個不可能的日期(有興趣的人可以參考這篇文章〈為什麼資料庫裡會有 2899 年?〉),字串欄位填空白。
我沒有機會訪問當年的設計者,所以我不猜他們為什麼這麼做。但這樣做買到了什麼,是看得出來的。
在那個年代,程式是用嵌入式 SQL 寫的——SQL 直接寫在 COBOL 或 C 的程式裡。每從資料庫取一個可能是 NULL 的欄位,程式就得多準備一個「指示變數(indicator variable)」,專門用來接「這格是不是空的」這個訊號。漏了的話,輕則報錯,重則程式拿著一個不合法的值繼續算。一個欄位一個,幾千個欄位就是幾千個。
全系統禁止 NULL,這個成本就一次歸零:每一支程式都可以放心假設,取回來的每一格都有值。
這樣的做法在那個年代並不特別。COBOL 程式初始化一個變數,預設就是文字填空白、數字填 0;同時代的 IBM DB2,欄位設成 NOT NULL WITH DEFAULT 之後,沒給值的時候,固定長度的文字欄位會自動填空白、數字填 0。「空白和 0 代表沒有」,是那一整個年代的慣例,不是哪個團隊的怪癖。
跟 2899 這個哨兵值(拿一個特殊的值來代表「沒有」)一樣,這是一個工程上划算的決定,不是偷懶。它在那套系統裡運作得很好,到今天也是。
麻煩發生在資料離開那套系統、被拿去分析的時候。
空白怎麼讓常見的缺值檢查一起失效
回到那個性別欄位。這是它實際的分布:
| 值 | 意思 | 佔比 |
|---|---|---|
2 | 女 | 70.36% |
1 | 男 | 22.02% |
| 空白 | 不知道 | 7.61% |
| NULL | — | 0 筆 |
編碼 1 是男、2 是女,跟身分證字號第一碼的慣例一樣。空白佔了 7.61%——大約每 13 個人就有一個。
每一種標準檢查都回報「完整」
平常我們怎麼檢查一個欄位有沒有缺值?大概三種做法:
- 用
WHERE sex IS NULL數缺值——回 0 - 比較
COUNT(*)和COUNT(sex):後者只數不是 NULL 的列,兩個一樣大就代表沒有缺值——兩個一樣大 - 用資料品質工具或 BI 的欄位剖析,看「完整度」——100%
三種方法,三個「沒問題」。它們沒有壞,它們都在忠實地回答同一個問題:這一欄有沒有 NULL?答案是沒有。
嚴格說,有些工具會把長度為零的空字串也算成缺值;但一個空白字元,多半還是被當成有值。
問題是,那不是你想問的問題。你想問的是「有沒有人不知道性別」,而這套系統把「不知道」存成了一個不是 NULL 的東西。
一套 NOT NULL 全開的系統,會讓常見的缺值檢查同時失效。你不是查不到問題,是被告知沒有問題。
後者比前者危險。查不到,你還會繼續查;被告知沒有,你就不查了。
至於要怎麼把空白抓出來,那是另一個題目;這篇先把它造成的後果講清楚。
三種女性佔比,全部算得出來,全部不同
那 7.61% 不會待在原地,它會跑進每一個用到這個欄位的數字裡。光是「女性佔比」這一格,就有三種算法:
| 算法 | 女性佔比 |
|---|---|
| 分母包含空白(女 ÷ 全部) | 70.36% |
| 分母排除空白(女 ÷ 有填的) | 76.16% |
用「不是男性」當女性(sex <> '1') | 77.98% |
最高和最低差了 7.6 個百分點。男女比也跟著從 1 : 3.19 變成 1 : 3.54。
前兩種是「分母怎麼選」的問題,只要講清楚,兩個都說得通。第三種不一樣,它不是規則不同,是算錯了。但它是三個裡面最容易被寫出來的那個——只要一個條件就寫完了。
同一個條件,NULL 和空白錯在相反的方向
sex <> '1'(sex 不等於 1)這句話,想表達的是「不是男性」。
如果這個欄位沒有值就存成 NULL,會發生什麼事?我在〈為什麼資料庫裡會有 2899 年?〉講過 SQL 的三值邏輯:NULL <> '1' 的結果不是 TRUE 也不是 FALSE,是 UNKNOWN,而 WHERE 只留 TRUE。所以性別未知的那群人會消失——既不在男性裡,也不在「不是男性」裡。
如果沒有值就存成空白呢?空白是一個真的值,空白不等於 '1',結果是 TRUE。所以他們會被算進「不是男性」——也就是被當成女性。
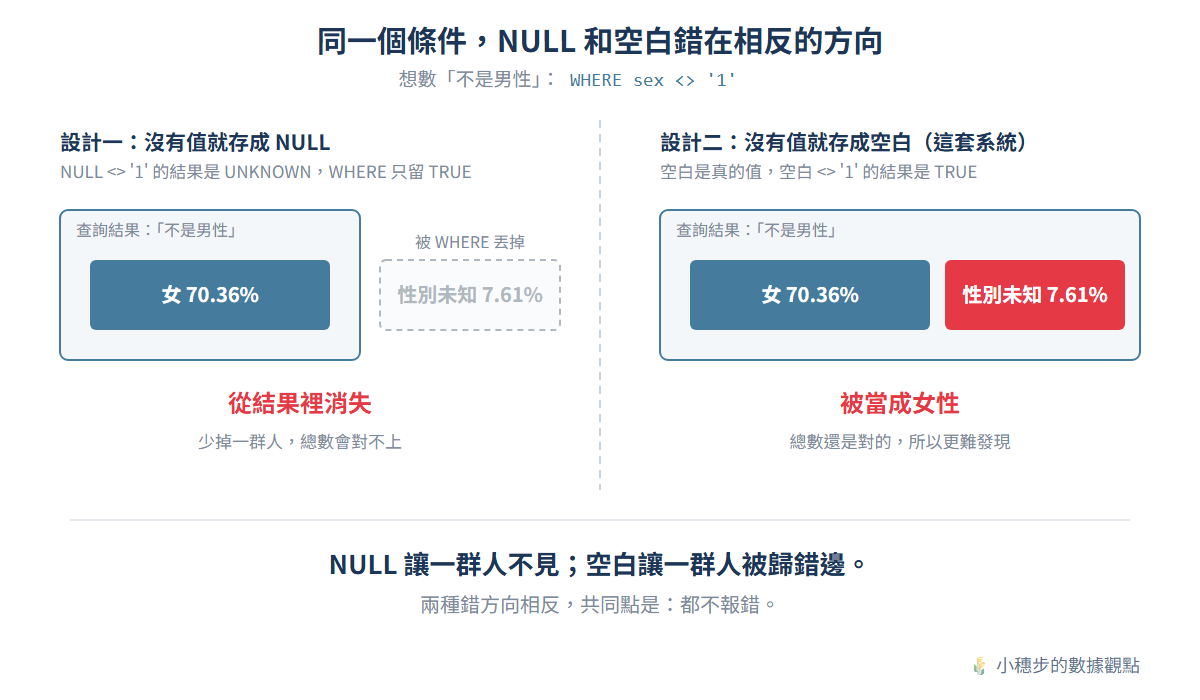
而空白這種錯更難發現,因為總數還是對的。這就是開頭 B 那份報表加得起來的原因:它沒有漏掉任何人,它只是把一群不知道性別的人,全部當成了女性。加得起來,不代表算對了。
還有兩個會讓使用資料的人誤解的地方
GROUP BY sex會多出一組,名字是一片空白。前端顯示成一個空的格子,看的人通常以為是排版問題。- 空白這個字元,在多數資料庫的預設排序裡排在數字前面。按性別排序的報表,第一列就是那群不知道性別的人。
那在來源端改回 NULL 不就好了?
發現之後,最直覺的想法是回到源頭修掉:
UPDATE customer SET sex = NULL WHERE TRIM(sex) = '';這句不會成功。欄位是 NOT NULL,資料庫會直接擋下來——這一格在結構上就不允許放 NULL。
那把 NOT NULL 這條規定拿掉呢?技術上做得到,但你動的不是一個欄位,是一個全系統的前提。那套系統裡的每一支程式,都是在「這裡永遠有值」這個前提下寫出來的,它們從來不需要處理 NULL。這條規定一拿掉,就得確認每一支讀這個欄位的程式,遇到 NULL 時不會出錯。在一套跑了幾十年的系統裡,這個回歸測試的範圍,就是 2899 那篇說的「沒有人敢批」。
那從今天起,在輸入畫面把性別改成必填呢?這能擋住新進來的空白,但已經存在的那 7.61% 不會自己變回來。
有人會說,那在來源加一個 view,把空白轉掉就好。只有一套系統的話,確實可以。但當你有好幾套系統、好幾種「不知道」的寫法時,這條路能走多遠,是另一篇的題目。
來源放不回去,解法就只能往下游走。
數據中台的做法:給「未知」一個名字
不翻成 NULL,翻成「未知」
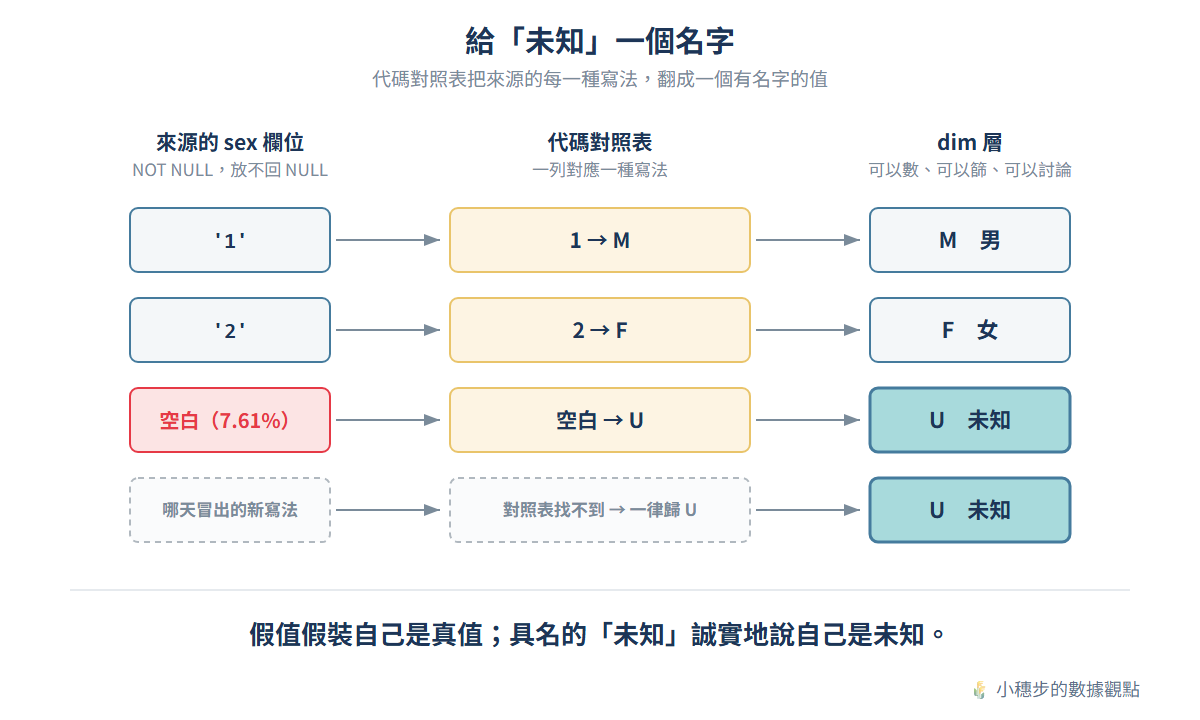
在 dim 層(數據中台整理好、要給人查的那一層)建一張代碼對照表,把來源的每一種寫法,對應成一個有名字的值:
| 來源系統 | 欄位 | 來源值 | 代碼 | 名稱 |
|---|---|---|---|---|
| 核心系統 | sex | 1 | M | 男 |
| 核心系統 | sex | 2 | F | 女 |
| 核心系統 | sex | (空白) | U | 未知 |
dim 層的客戶資料就不再存 1、2、空白,而是存對照過的代碼和名稱:
SELECT c.customer_id,
       COALESCE(m.code,  'U')    AS gender_code,
       COALESCE(m.label, '未知')  AS gender_label,
       CASE WHEN m.code IS NULL THEN 'Y' ELSE 'N' END AS is_unmapped
  FROM ods_customer c
  LEFT JOIN code_map m
    ON m.source_system = '核心系統'
   AND m.source_column = 'sex'
   AND m.source_value  = COALESCE(NULLIF(TRIM(c.sex), ''), '(空白)');
COALESCE 的意思是「前面是空的,就用後面這個」。空白會先被統一成 (空白) 這個明確的值,再去對照表查。對照表裡找不到的值,一樣歸成「未知」,但會被 is_unmapped 標出來——哪天冒出新寫法,檢查會亮燈,而不是被悄悄吞進「未知」。
為什麼這次不用 NULL
在〈為什麼資料庫裡會有 2899 年?〉那篇,日期欄位我選擇翻譯成 NULL;這一篇的性別欄位,翻譯成 NULL 反而會出錯。差別在於這一格要拿去做什麼。
失效日要拿來算:減法、比大小、判斷有沒有過期。假日期一被拿去算,就會算出幾百年,所以我讓它真的空。(Kimball 自己的範例用的是一個遠未來的日期,換來範圍條件比較好寫。兩種做法都有人用,差在你比較怕哪一種錯。)
性別要拿來分類:分組、計數、算佔比。一個分類要能被數,就得有名字。NULL 在分組裡雖然會自成一組,但只要碰到 <>、NOT IN 這類條件,它就會像前面那樣整群消失。
同一個「沒有」,在不同用途下有不同的正確答案。
資料倉儲領域最常被引用的 Kimball Group,在 2003 年的一篇設計建議(Design Tip #43)裡就寫過兩件事。第一,維度的屬性(性別、地區這類描述性的欄位)不要放 NULL,改放「Unknown」「Not provided」這類有描述的字串,因為 NULL 在報表和下拉選單上只會顯示成一片空白。第二,事實表裡要拿來加總的數值,則要保留 NULL、不要填 0,因為加總和平均會正確略過 NULL。
第一點就是這一節的「未知」,第二點則提醒:數字欄位的「沒有」,不要用 0 代替。所以問題從來不是用不用 NULL——連 Kimball 都叫你別在維度裡放 NULL。差別在於那個「沒有」,有沒有被取一個名字。
Kimball 也提醒,「沒有」分兩種:一種是有答案、只是沒記錄(Unknown),一種是這一格本來就不適用(Not Applicable)。來源分得出這兩種,對照表就多一列;這套系統分不出來,所以只有一個「未知」。
名字給出去之後,三件事變得不一樣
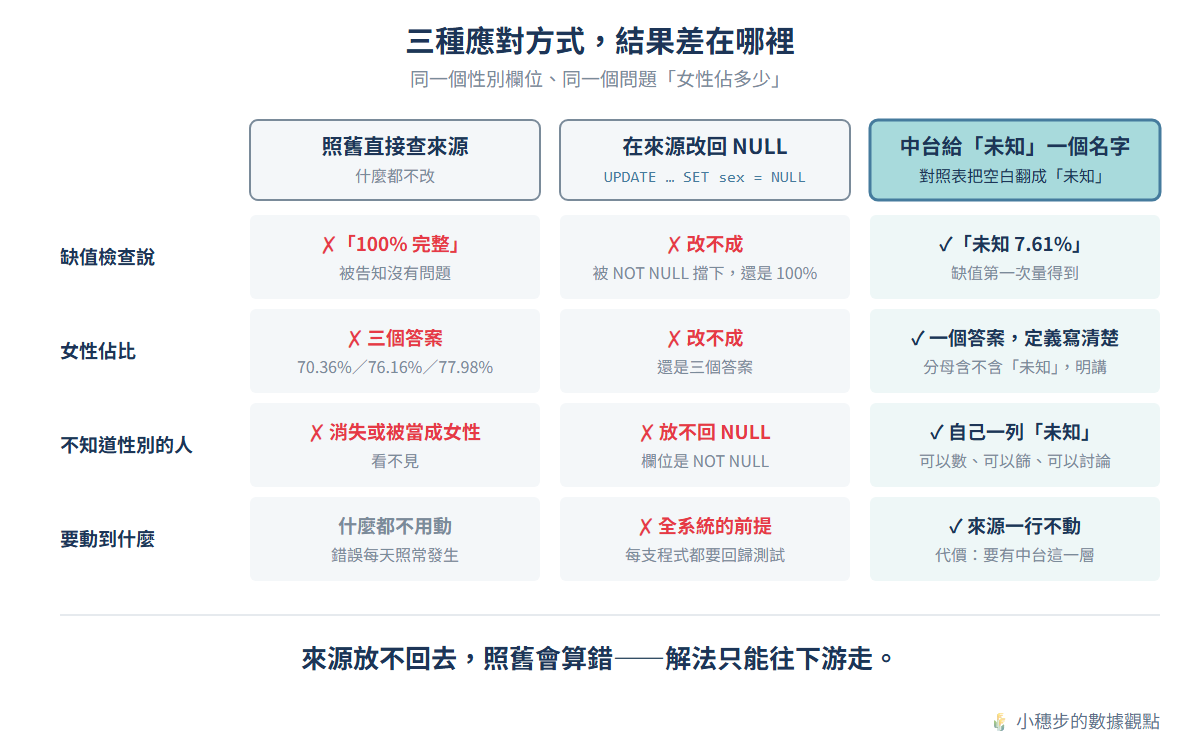
一、報表加得起來,而且沒有人被歸錯邊。
| 性別 | 佔比 |
|---|---|
| 女 | 70.36% |
| 男 | 22.02% |
| 未知 | 7.61% |
「未知」自己是一列,站在報表上,誰都看得見。
二、「分母要不要含未知」從一個意外,變成一個選擇。
以前那三種女性佔比,差別藏在 SQL 的寫法裡,寫的人自己可能都沒發現。現在「未知」是一個具名的類別,要不要放進分母,你得明確地決定,而且這個決定會寫在報表的定義裡。70.36% 和 76.16% 都可以是對的答案,只要說清楚是哪一種。77.98% 那種錯法則不會再發生——沒有人會把「未知」寫成「女」。
三、缺值第一次變成一個量得到的指標。
以前的品質報告寫著 100% 完整。現在你可以問:「未知」佔多少?這個月比上個月多還是少?新進來的資料裡還有沒有?這些問題以前不存在,因為工具告訴你沒有缺值。
這一步和 2899 那篇的翻譯層,不是同一件事
2899 那篇的對照表,做的是「把約定寫下來」:2899 代表還沒結束,這件事原本只在程式碼裡,現在寫進了中台。
這一篇的對照表多做了一件事:給不知道一個名字。來源把「不知道」偽裝成一個看起來有值的空白;中台把它變回一個誠實的「未知」,放在大家看得到的地方。
結語
回到開頭那兩份報表。B 那份看起來比較乾淨,因為它加得起來;A 那份看起來比較亂,因為它少了 7.6%。
但 A 那份才是誠實的那一份。它少掉的那 7.6%,就是這套系統裡不知道性別的人——它只是不知道該怎麼把他們講出來。
假日期、空白,都是同一種東西:一個偽裝成有值的「沒有」。它們在那套系統裡運作得很好,也不報錯,但它們讓外面的人和工具,把「不知道」誤認成「知道」。
假值假裝自己是真值;具名的「未知」誠實地說自己是未知。
如果讓 AI 來寫開頭那兩份報表,它看到 NOT NULL,會比 A 同事更早相信那個 100%。這條線,我留到之後專門寫一篇。
延伸閱讀
如果你也走在自己的路上,歡迎訂閱《小穗步電子報》——我會把每一次的覺察與練習,寫成信寄給你。→ 訂閱小穗步電子報