數據中台同一筆變更,該套到哪一列?導入 CDC,怎樣判斷舊表值不值得補主鍵?
有唯一鍵,拿它當 CDC 的判斷就可以了嗎?主鍵、唯一鍵、rowid 在 CDC 套用時各自怎麼壞,Debezium 實測結果,以及一張舊表該先補主鍵還是先接 CDC 的判斷。
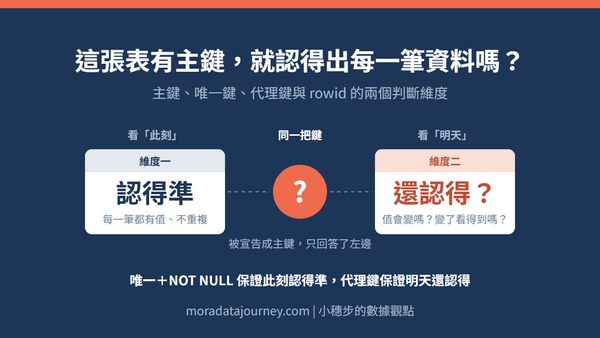
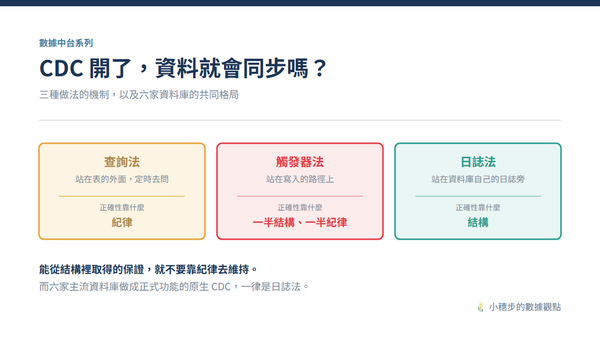
〈數據中台 CDC 開了,資料就會同步嗎?〉的結論是:CDC 把來源系統的每一筆變更都讀出來了,一筆不漏。這個系列的前傳〈這張表有主鍵,就認得出每一筆資料嗎?〉(以下簡稱「前傳」)拆出了判斷一把鍵的兩個維度:此刻認得準,明天還認得。
導入 CDC 的過程中,有一個問題同仁不斷提起:「這張表有唯一鍵,拿它當 CDC 的判斷就可以了吧?」用唯一鍵,會不會有哪些狀況,讓資料同步過去了、最後卻不能用?這篇是我的紀錄:下次再有人問,我會這樣回答。
CDC 讀出來的每一筆變更長這樣——「有一列被改了,改之前是這樣,改之後是那樣」。接下來的問題很單純,也很難:目標端有一千萬列,這一筆要套到哪一列?
歷史悠久的資料庫,留著不同年代的技術痕跡:近期的表有主鍵,有些表只有唯一鍵(UK),有些表兩者都沒有,只能拿 rowid 撐著。所以導入 CDC 不只是套用工具,還得依每張表的現況判斷。如果兩者都沒有,要先建好 PK 再設定 CDC?還是先導入 CDC,之後補上 PK 再更新鍵值?這是現實裡一定要面對的兩個問題。
三種狀態,各自能接 CDC 的條件不同。差別的理論前傳談過了;這篇要回答三件實務的事:三把鑰匙在 CDC 套用那一步各自會怎麼壞、一張沒有主鍵的舊表,值不值得花力氣把主鍵補上,以及要補的話,先補主鍵再接 CDC,還是先接再補。
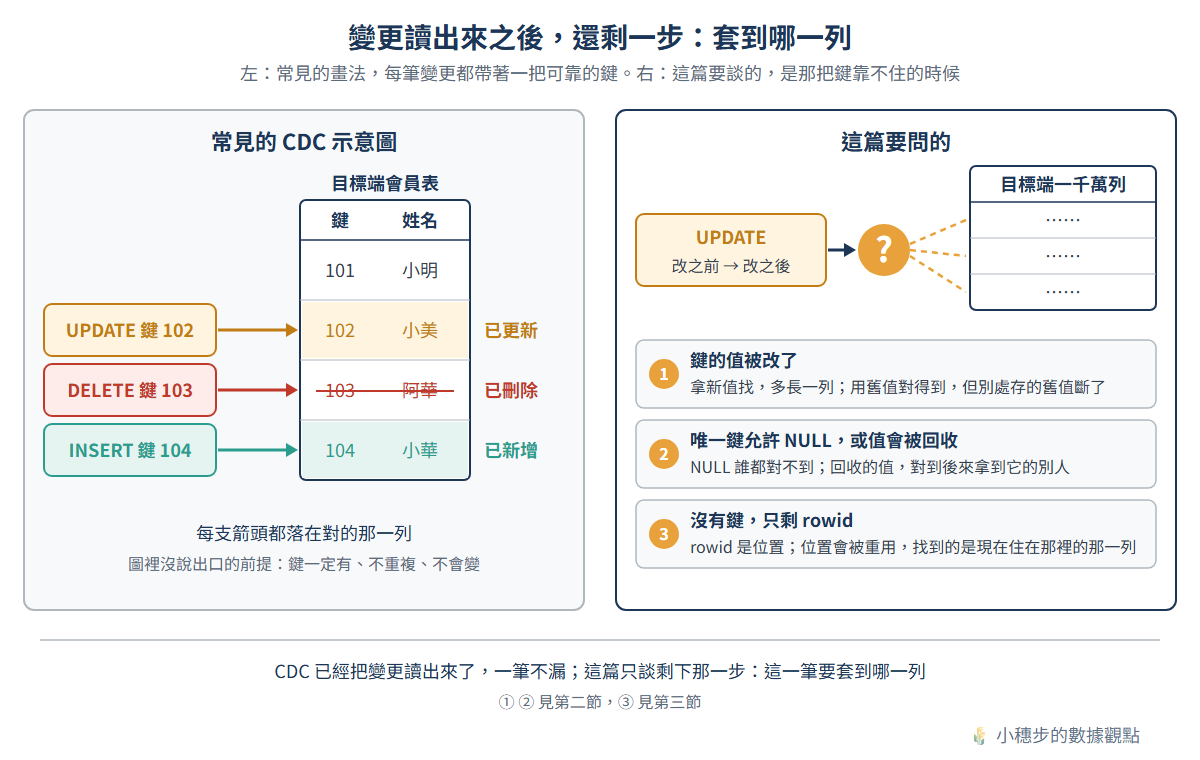
一、三把鑰匙,三種不同性質的東西
先把三個名詞各自在講什麼講清楚。它們經常被放在同一個句子裡比較,但其實不是同一種東西。
- 主鍵(PK)、唯一鍵(UK):資料庫上的宣告。主鍵不能重複、不能是空的;唯一鍵只管不重複。前傳談過,宣告的是角色,不保證值不會變
- rowid:不是宣告,是事實描述——這一列現在放在磁碟的哪個位置
主鍵、唯一鍵是邏輯上的約定,rowid 是實體儲存的狀態。
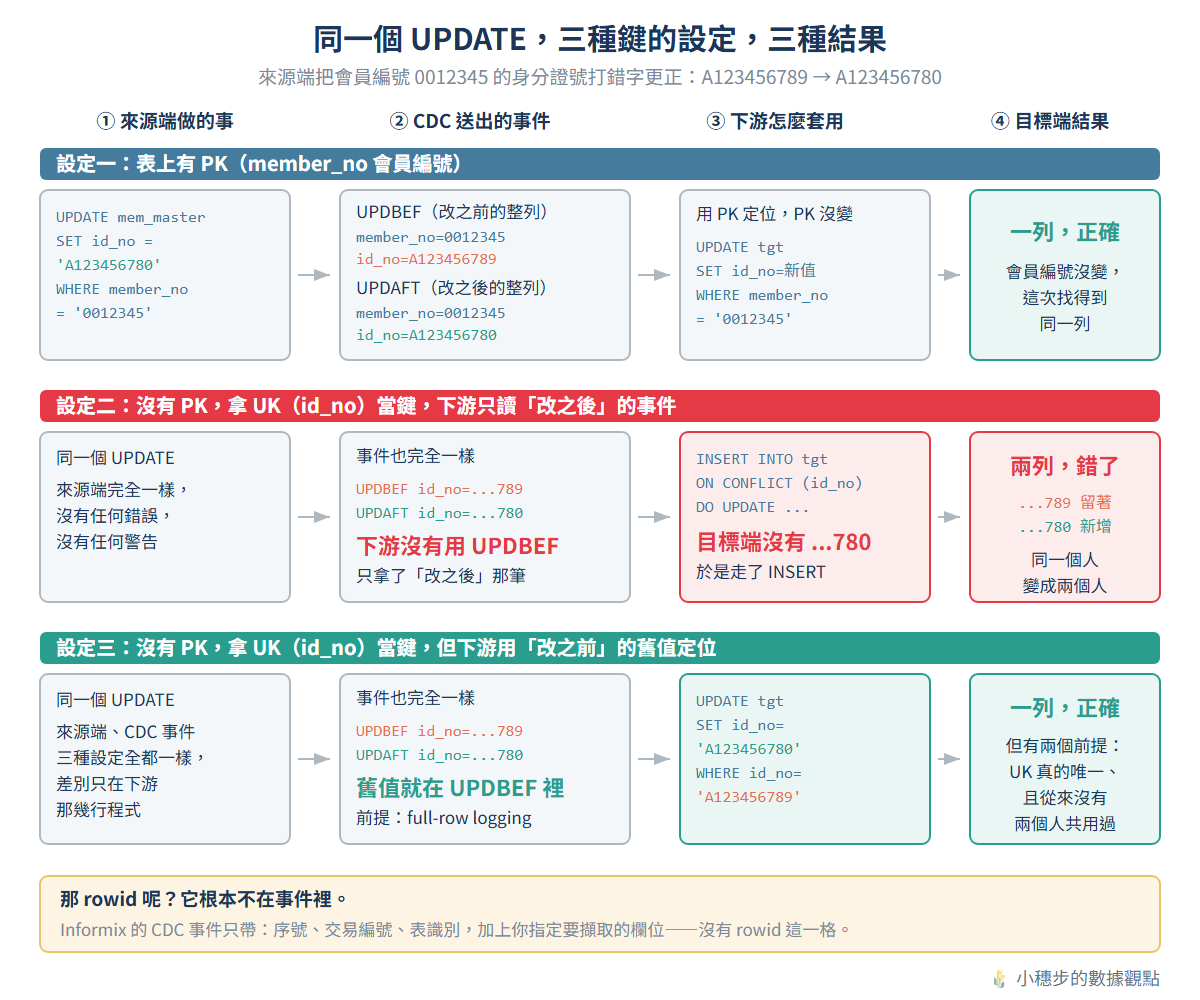
一個具體的例子
來源系統把小明的身分證號更正了——原本打錯字,A123456789 改成 A123456780。他的會員編號 0012345 沒有變。
CDC 把這筆更新送出來,事件裡有兩份資料:改之前的整列、改之後的整列。接下來看下游拿它怎麼辦:
設定一:這張表有主鍵(會員編號)
UPDATE 目標表
   SET id_no = 'A123456780'
 WHERE member_no = '0012345';
會員編號這次沒變,所以找得到同一列。一列,正確。
設定二:這張表沒有主鍵,身分證號宣告為唯一鍵(UNIQUE+NOT NULL),下游只讀「改之後」那份
INSERT INTO 目標表 ...
ON CONFLICT (id_no) DO UPDATE ...;它拿新的身分證號去撞目標端。但目標端還沒有 ...780 這一列,撞不到,於是走了 INSERT。
結果是兩列:舊的 ...789 永遠留著,新的 ...780 長出來。同一個人變成兩個人。
這不是假想的寫法。第四節換成開源工具 Debezium 實跑,目標端照預設設定時,得到的也是這兩列,只是原因不同:不是只讀了新值,而是刪除事件被略過。
設定三:同樣只有宣告的唯一鍵,但下游用「改之前」的舊值定位
UPDATE 目標表
   SET id_no = 'A123456780'
WHERE id_no = 'A123456789'; -- 舊值來自 CDC 事件裡的「改之前」一列,正確——但這個正確有兩個前提,少一個都不成立:
- 身分證號真的宣告了 UNIQUE,而且每個欄位都是 NOT NULL。 唯一約束本身不禁止空值——PostgreSQL 允許多列在該欄都是 null1。空值的那幾列,CDC 認不出誰是誰
- CDC 被設定成用它。 PostgreSQL 預設只記主鍵欄位的舊值,要改用唯一鍵,得另外指定那個索引,而且規定它只能包含 NOT NULL 的欄位2;Oracle 則是在沒有主鍵時,自動挑一個不可為空的唯一索引3。少了這個設定會怎樣,第四節有實測
這篇只談宣告在資料庫上的鍵:宣告過的鍵才查得到、留得下痕跡。兩個前提都成立,唯一鍵在「此刻認得準」這件事上就跟主鍵沒有差別。至於「明天還認不認得」,主鍵也一樣不保證——那是下一節要談的。
這個錯的可怕之處
設定二那個結果,沒有任何一個環節報錯。來源系統正常、CDC 正常、下游程式也沒拋例外。三個環節都「成功」,只有資料是錯的。
之後小明的訂單會掛在哪一列?看它帶的是哪個身分證號。統計人數會多一個。而沒有任何一支程式會告訴你。
所以三把鑰匙的差別,不在它叫主鍵還是唯一鍵,而在前傳那把尺量的兩件事:此刻能不能認準一列,明天還認不認得同一列。收成一句話:
唯一+NOT NULL 保證此刻認得準,代理鍵(Surrogate Key)保證明天還認得。此刻認得準與明天還認得 CDC 兩件都要。
設定一會對,不是因為會員編號被宣告成主鍵,是因為這次更正沒有動到它。前傳談過,會員編號是系統發號的自然鍵:印在會員卡上,合併時照樣會變,這次只是剛好沒動到。「此刻認得準」與「明天還認得」平常看起來很像,只有在「身分改變」的時候才會分岔。
二、唯一鍵會壞的三種方式
假設那一欄確實在資料庫上宣告了 UNIQUE。夠了嗎?
還不夠。唯一鍵有三種壞法,第一種可以擋,後兩種擋不住。
第一種:鍵的值被更新了
就是第一節那個身分證號打錯字的例子。用「改之前」的舊值定位就能解決,因為 CDC 事件裡本來就有那份舊值。
這一種是可控的,前提是下游程式真的去讀了舊值。如果你們的串接是這樣做的,那第一種壞法你們已經擋住了。
值改了,CDC 靠舊值還是對得到這一列;對不到的是其他還記著舊值的地方——例如小明的訂單,存的還是舊的身分證號。
第二種:唯一鍵允許 NULL
第一節的第一個前提不成立時,就是這一種:沒填身分證號的會員可以有很多位,像小美,每一位的身分證號都是 NULL。
前傳談過,NULL 用 = 比對永遠不成立。落到 CDC 套用那一步,後果是:ON CONFLICT (id_no) 永遠不會觸發,小美每更新一次,目標端就多一列;刪除時帶著 NULL 回來找,一列也刪不到。
這一種在套用端擋不住,因為 NULL 沒有值可以對。第四節會看到,換成 Debezium,它連同步都起不來。
第三種:那個值被回收再利用
第三種最難防,因為它發生在時間軸上。
一個號碼今天屬於小華,小華的資料被刪掉之後,這個號碼被釋放,明天發給了小強。對來源系統來說完全合理——那個號碼就是一個號碼。
但目標端看到的是:先來一個刪除、後來一個新增。如果這兩個事件的順序錯了、或者刪除那個事件在某次故障中漏掉了,目標端那一列就會變成小華的舊資料配上小強的新資料。
用舊值定位擋不住這一種,因為舊值本身就是那個被回收的號碼。
後兩種擋不住,原因各有一個。第二種,NULL 根本不是一個值;第三種,唯一鍵從來沒有承諾過「這個值永遠代表同一個東西」。 它只承諾此刻不重複。身分證號更正、號碼回收——這些都不是資料錯誤,是業務上正當的事件,而唯一鍵對它們沒有任何保護。主鍵的約束也沒有承諾這件事;前傳談過,能承諾「永遠代表同一個」的不是約束,是值的來源。
三、那 rowid 呢?它看起來可以找到對的位置
沒有主鍵、也沒有可靠的唯一鍵,還剩下什麼?很多人會想到 rowid——每一列都有,不用建、不用維護,而且又短又快。
它的問題在於,它回答的是另一個問題。
鍵回答「這一列是誰」,rowid 回答「這一列現在放在哪裡」。前者是身分,後者是地址。地址會變,而且會被下一個人用。
前傳示範過:同一個人會換位置,同一個位置會換人;前傳引過的 PostgreSQL 與 Informix 官方文件,也都建議用主鍵,不要靠 rowid。這裡只談 CDC 會碰到的部分。
現實狀況:如果真的什麼鍵都沒有,怎麼辦?
我們站在巨人肩膀上,資料庫廠商自己遇到這個狀況時的選擇很值得看。Oracle 的文件寫著它的判斷順序:有主鍵就記主鍵;沒有主鍵但有不可為空的唯一索引,就挑一個;兩個都沒有的時候,除了大型欄位以外,整列的所有欄位都記下來3。
它寧可把整列都記下來,也不用位置當識別。
這兩種兜底方案的差別,正好是一組漂亮的對照:
| 全欄位當鍵 | rowid | |
|---|---|---|
| 定位速度 | 很慢——條件帶所有欄位,沒有索引可用 | 很快——單一窄欄位 |
| 什麼時候失效 | 只有真正完全重複的列 | 表重組、更新、清理、位置被回收 |
| 失效時的錯誤型態 | 找不到 → 沒更新(吵) | 命中錯的列 → 改到別人(安靜) |
| 可不可能被發現 | 高:筆數對不上,對帳會叫 | 低:筆數完全正確,內容是錯的 |
表裡那一格「只有真正完全重複的列」,不是理論上的假設。SQL 本來就允許一張表裡有完全相同的列:PostgreSQL 的官方文件寫著,SQL 不會替每一列指派唯一的識別碼,所以一張表裡可能有好幾列完全相同5。這也是沒有主鍵的舊表之所以能存在的原因。
全欄位與 rowid 剛好互換:一個慢但錯得大聲,一個快但錯得無聲。
當你無法保證正確的時候,寧可選會吵的那一種錯。 因為吵的錯會被修,安靜的錯會被相信。
還有一個更現實的問題
就算你願意承擔上面的風險,在日誌法的路徑上你可能根本拿不到 rowid。
Informix 的 CDC 事件,每一筆的標頭只有四格:序號、交易編號、表識別、保留欄位,後面接的是你指定要擷取的那些欄位4。沒有 rowid 的位置。
所以如果一套串接宣稱「沒有鍵就用 rowid」,值得問一句:那個 rowid 是從哪裡來的?可能的答案有幾種——另外回頭去查來源(那就混進了查詢法,延遲與一致性都變了)、那張表剛好是特殊設定的表、或者其實是定期整批重抓。這三種的風險完全不同。
四、透過 Debezium 與 PostgreSQL 模擬上面的情境
實務上,套用那一步通常不是自己寫程式,而是直接用現成的 CDC 工具,例如開源的 Debezium。它是一組建在 Apache Kafka 上、相容 Kafka Connect 的 connector,每個 connector 對應一種資料庫,在資料列被新增、修改、刪除的當下,把每一筆變更變成事件送進 Kafka6。
我把同一串事件換成 Debezium 實跑一次:來源端一台 PostgreSQL,經過 Debezium 與 Kafka,寫進另一台 PostgreSQL,再逐列比對兩端7。
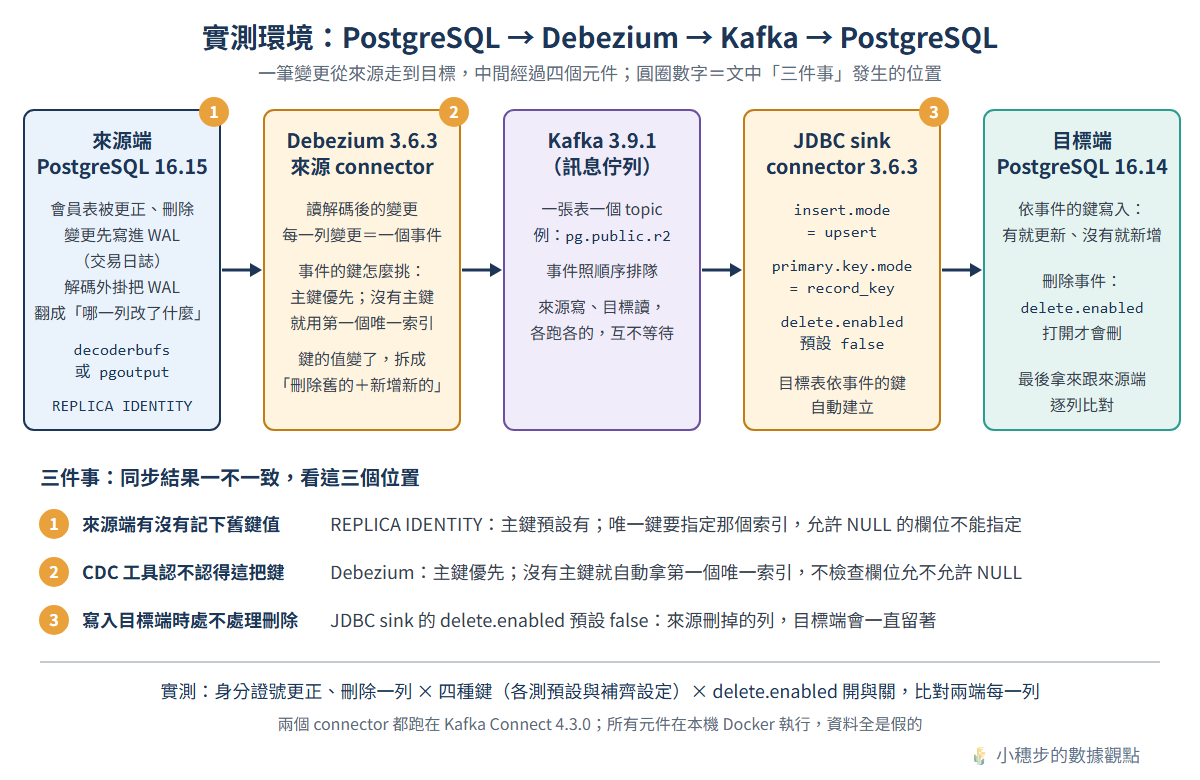
前傳把五種鍵排了名次,量的是鍵本身:此刻認不認得準、明天還認不認得。這裡換一個問題:把鍵交給 Debezium,兩端同步得一不一致?同一張會員表,做同一件事:小明的身分證號更正、刪除一列。除了 rowid,四種鍵各跑一次,每一種都看兩個版本:照預設設定(只多設了一項:目標端依鍵寫入,有就更新、沒有就新增),以及把設定補齊之後。
這裡的目標端都是「依鍵更新」的同步表;如果目標端是只新增、保留每一筆事件的流水表,鍵扮演的角色不同,那是另一個題目。
| 鍵 | 照預設設定時 | 設定補齊後 |
|---|---|---|
| 第 1 名 代理鍵當主鍵 | 更正沒事;來源刪掉的列,目標端留著8 | 目標端 delete.enabled=true → 一致 |
| 第 2 名 業務值當主鍵 | 更正後多一列,舊的沒被刪 | 目標端 delete.enabled=true → 一致 |
| 第 3 名 業務值當 NOT NULL 唯一鍵 | 更正後沒有事件,目標端停在舊值9 | 來源端 REPLICA IDENTITY USING INDEX2+目標端 delete.enabled=true → 一致 |
| 第 4 名 允許 NULL 的唯一鍵 | 同步一開始就失敗、停擺 | 無解:允許 NULL 的欄位不能指定成 REPLICA IDENTITY2 |
rowid 不在表裡:Debezium 不拿位置當鍵。
這張表有三件事值得停下來看。
第一,照預設設定,四種鍵沒有一種是一致的,連代理鍵也一樣。 負責寫入目標端的元件預設不處理刪除8。第一節設定二那個「一個人變兩個人」在這裡也長出來了,原因是刪除事件被略過。
第二,唯一鍵補上一個來源端設定,結果就跟主鍵完全一樣。 Debezium 在沒有主鍵時,會自己拿第一個唯一索引當鍵7;它缺的只是舊值,也就是第一節兩個前提的第二個。如果改用 PostgreSQL 內建的解碼方式(pgoutput),少了這個設定,連來源端的更新都會直接失敗10。
第三,允許 NULL 的唯一鍵是唯一救不回來的。 第二節說它在自己寫的程式裡會安靜地多長一列;在 Debezium 下它反而會吵,同步一開始就停擺,但不管怎麼設定都修不好。
不管用哪一套工具,我判斷兩端會不會一致,都先問三件事:來源端有沒有記下舊鍵值、CDC 工具認不認得這把鍵、寫入目標端時處不處理刪除。
但這三件事管的只是「同步一致」:目標端這一列,跟來源端一不一致。設定補齊之後,前三種鍵都做得到,前三名在同步這一關打平,名次沒有因此改變。它們真正的差別仍在前傳那一層:值會不會變。前傳提過,業務值一被更正,Debezium 會送出「刪除舊的+新增新的」9,目標端照做,這一列是一致的;但中台裡掛在舊值上的訂單、歷史紀錄,全都斷了。會員合併也一樣。這一層,同步工具管不到。 所以要不要補主鍵,不能只看同步測試有沒有過,要看這張表的值會不會變、變了會斷掉多少東西,這是下一節要算的。
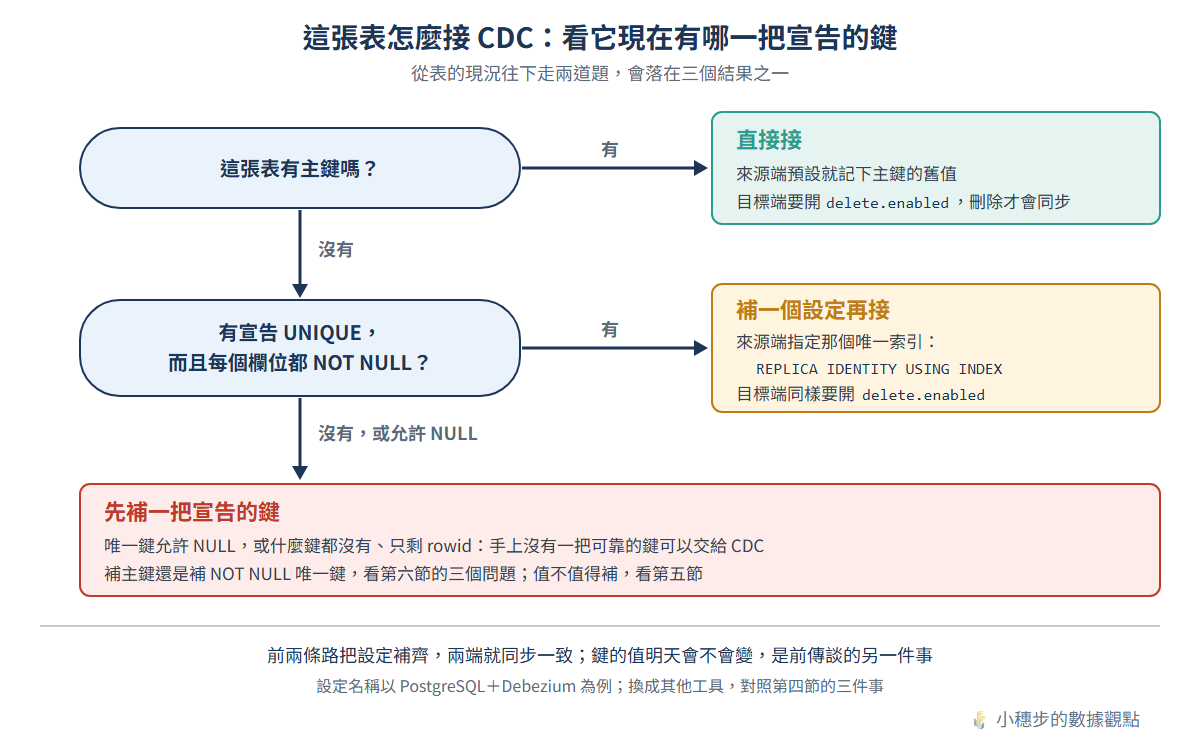
五、那到底值不值得補主鍵?
判斷圖走到「先補一把宣告的鍵」的表,接下來要問的是:值不值得補?
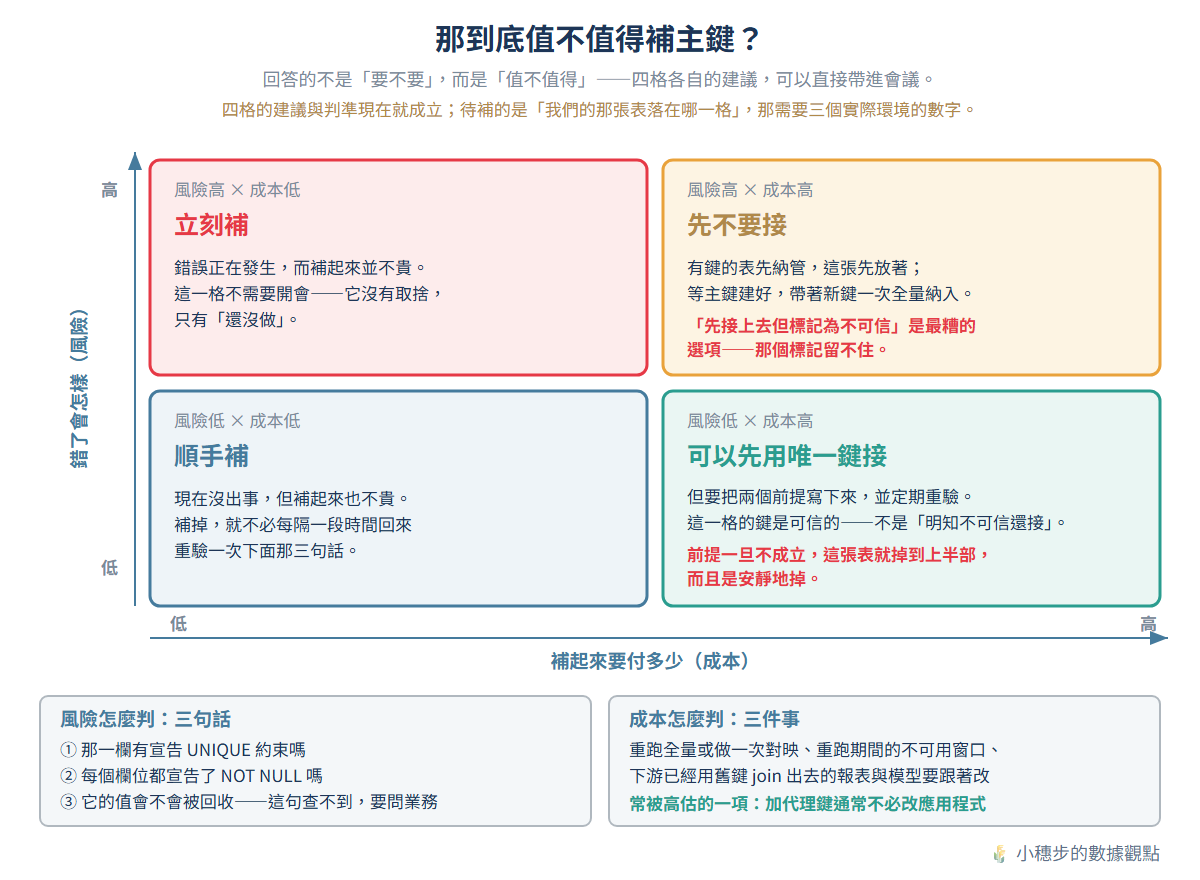
一個常被高估的成本:加一個代理鍵通常不必改應用程式——前提是應用程式的 INSERT 有寫出欄位名。越古老、版本越舊的系統越可能沒寫,這個成本也就越高。但現在可以用 AI 全面盤點程式碼,把成本降下來。所以只從商業邏輯的正確性來看,我個人傾向加入 PK。
六、先接 CDC,還是先建主鍵?
第四節那張判斷圖,一次只看一張表。但實務上這些決定會互相牽動:今天這張表怎麼接,決定了明天要付什麼帳;一張表的決定,會拖著跟它 join 的表一起走。這一節談的就是牽動。
這一題在實務上比前面所有分析都常見:現在就要接,主鍵之後再說,可以嗎?
可以,但代價不是固定的,它會隨時間長大。我把理由拆成三層。
第一層:重跑全量是遲早要付的,問題是付一次還是付兩次
如果你已經知道現在寫進目標端的資料是錯的,那目標端現有的資料就不是要保護的資產,是要清掉的負債。遲早要重跑一次全量。
於是算式很單純:
- 現在建主鍵 → 建好之後重跑一次,結束
- 先用唯一鍵接上去 → 現在跑一次(錯的),將來換鍵再跑一次(對的)。中間那段時間資料是錯的,而錯誤量每天都在長
第二層:換鍵那天,你要用什麼把新舊對起來?
這是最容易被忽略的一個坑。
換鍵的時候,目標端的舊資料身上沒有新的主鍵值。要把它們配起來,只能靠舊的那把鍵。
如果舊鍵現在還可信,例如換鍵是因為它是基礎表、不是因為它出錯,這件事軟體做得到:用舊鍵做一次對映,把新主鍵補上;Debezium 也可以一邊同步、一邊把整張表分批重讀一次11,重讀時不必暫停同步。
但如果換鍵正是因為舊鍵不可信,那就是雞生蛋。 你要拿一把不可信的鍵,去對出可信的結果。這時「之後再換」就等於「之後再重跑一次全量」,你只是把成本往後推,而且推遲期間資料是錯的。
第三層:如果下游有很多表靠同一把鍵串起來
多張表沒有主鍵、靠同一把會變的業務鍵 join,錯誤不會只待在一張表裡,它會一致地擴散到所有相關的表。
舉個例子。第一節設定二那次更正之後,目標端的會員表裡,小明變成 ...789 和 ...780 兩列。訂單表、點數表都用身分證號去 join 會員表:更正前的訂單掛在 ...789,更正後的掛在 ...780,點數也拆成兩半。逐張表對帳,每一筆訂單都找得到會員,筆數全對;但每一張用到會員的報表,客戶數都多一位,小明一個老客人被算成兩個新客,回購率跟著被低估。
一致的錯比零散的錯難發現——因為每張表之間互相「對得起來」,對帳看不出問題。
而且換鍵那天不是換一張表,是 N 張表要同時換、它們之間的關聯要同步重建。N 張表同時切換的難度,遠高於 N 倍的單表切換。
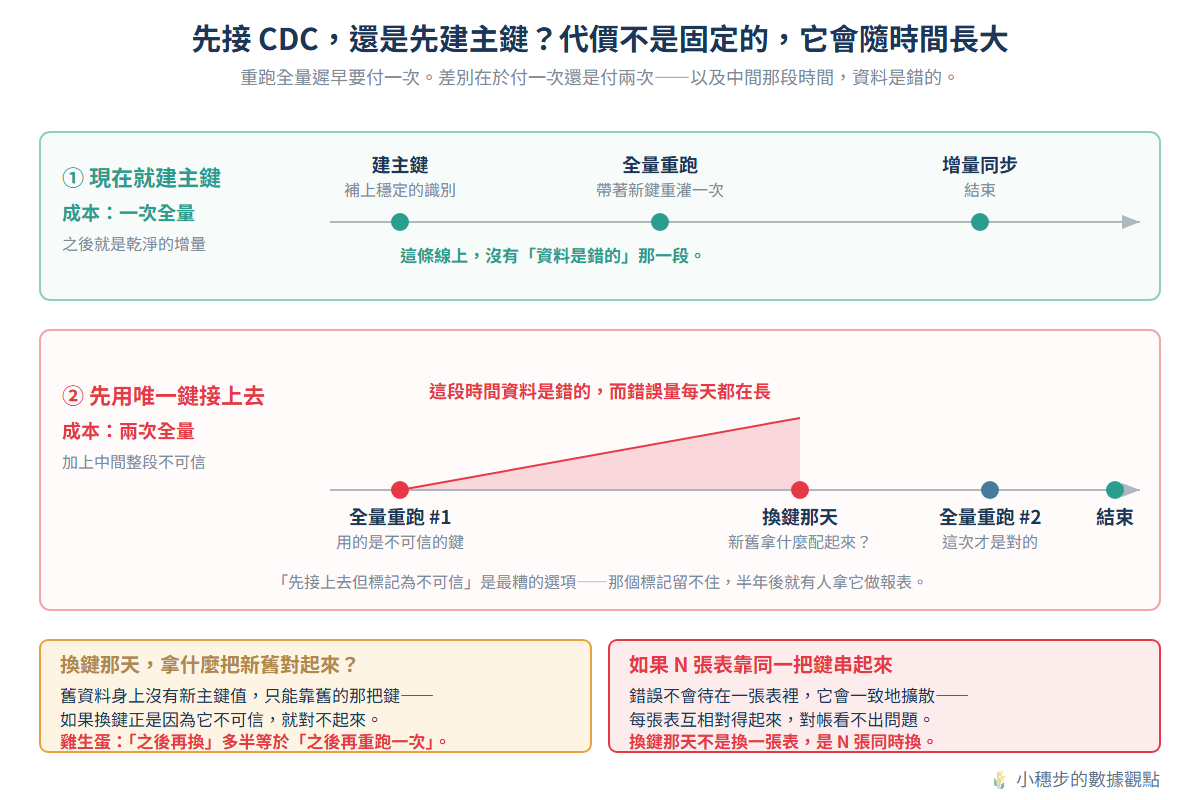
如果真的來不及,那就分批納管
CDC 有期限、主鍵短期內建不起來——這在現實裡很常見。這時候的做法不是「全部先用錯的鍵接上去」,而是:
- 先納入那些有主鍵、或有宣告 NOT NULL 唯一鍵的表,這些現在就能安全同步
- 那張重要但沒有鍵的表先不要接
- 等它的主鍵建好,帶著新鍵一次全量納入
「先接上去但標記為不可信」是最糟的選項——因為那個標記留不住。半年後就會有人拿它做報表,而那個人不會知道它不可信。
我怎麼排這些決定
補主鍵,還是分批納管?每次遇到這個選擇,我的判斷原則都一樣:不是二選一,而是依每張表的現況判斷。我用以終為始的方式,從最終的數據應用與決策往回想,問三個問題。任一個答「是」,就先建主鍵,再接 CDC:
- 這張表重要,而且唯一鍵已經不能確保業務邏輯正確嗎? 第二節的三種壞法,只要有一種已經在發生,就是。
- 它是基礎表嗎? 後續很多表、很多報表都以它為起點,它的鍵一換,後面全部跟著換,也就是第三層說的擴散。
- 之後再更新主鍵,會是更大的工程嗎? 如果是,現在的代價就是最便宜的代價,也就是第一層說的「付一次還是付兩次」。
三個都答「否」,我會先用唯一鍵(UK)接,前提是第一節那兩個前提都成立。連唯一鍵都沒有,就先建一個唯一鍵,因為沒有唯一鍵,資料一重複,套用就會判斷錯誤,而且不會有人通知你。確認這張表真的已經沒有在使用,才會用 rowid;不過既然確認沒有在用,也可以不必搬到目標資料庫,或者做一次全量複製就夠了。
排完順序之後,還有一個決定會回頭影響前面的選擇。
先不接,也是一個決定。 分批納管裡「先不要接」的那張表,下游不會因此停下來等。等不到資料的人會自己繞路,例如直接去來源撈。繞出來的路一旦被拿去做報表,就比晚一點接更難收回。所以先不接,要同時給出兩件事:主鍵預計什麼時候建好,以及在那之前,資料從哪裡來。
兩個必須誠實面對的質疑
第一,「建主鍵」是在別人的系統上動刀。 來源系統往往不是資料團隊管的,有時甚至是外購的套裝系統。這篇給的所有建議,都要先過「你有沒有立場要求這件事」這一關。如果沒有,但這件事很重要,那就要發揮影響力,讓各方一起完成這件事,這是另一個層次的功課。如果真的都不能動,那分批納管就不是次佳解,是唯一解。
第二,加一個流水號當主鍵,是不是在逃避找出真正的業務鍵? 這個質疑值得認真回答,但我的答案是否定的。業務鍵看起來穩定,多半只是還沒被改過——如前傳所引,Codd 在 1979 年就指出,由使用者決定的鍵,終究會被使用者改12;這篇的身分證號更正、前傳的會員合併都是例子。所以兩者不是二選一:代理鍵當系統內部的身分,業務鍵留著給人查詢和對帳,兩者都需要,只是在不同流程中扮演的重要性不同。 業務意義沒有被丟掉,只是不再拿來認人——CDC 要的本來就是穩定的識別,不是業務意義。
七、鑰匙的功能不是開門,是認人
主鍵、唯一鍵、rowid,三者在「同一筆變更該套到哪一列」上的差別,其實可以收成一句話:
rowid 說的是「這一列現在放在哪裡」,唯一+NOT NULL 說的是「此刻認得準」,只有一個沒人會去改的值,才說得出「明天還是這一列」。
CDC 每一秒都在問「這一列是誰」。你給它地址,它會找到那個位置上現在住的人;你給它一個此刻不重複的值,它會在那個值改變或被回收的那一天弄錯——而這兩種錯,都不會有人通知你。
回到同仁的那個問題:有唯一鍵,當 CDC 的判斷就可以了嗎?
我的回答分兩層。在同步這一關,可以,而且跟最後的做法不衝突:照第四節那張判斷圖把設定補齊,唯一鍵就能跟主鍵一樣一致。但資料同步過去,不等於最後能用。唯一鍵的值會被更正、被回收,允許 NULL 時連認都認不出來;這些錯不會在同步時報錯,而是在報表裡變成多出來的客戶、斷掉的訂單。所以要讓最末端的決策能被信任,我的做法是:同步交給設定,身分交給主鍵。這張表如果重要、是基礎表,或以後再改主鍵會更貴,就先建主鍵再接 CDC;三個都不是,唯一鍵加上補齊的設定就夠了。
唯一+NOT NULL 保證此刻認得準,代理鍵(Surrogate Key)保證明天還認得。導入 CDC 的目的,不只是讓來源和目標資料庫一致,那只是第一關;更重要的是讓最末端的決策能被信任。所以此刻認得準與明天還認得,在 CDC 這一關同等重要。
參考資料
- PostgreSQL 官方文件,Constraints:在唯一性比較中,兩個 null 不視為相等;因此即使有 unique 約束,仍可存進多列在該欄為 null 的資料。https://www.postgresql.org/docs/current/ddl-constraints.html (查證日 2026-09-19) ↩
- PostgreSQL 官方文件,ALTER TABLE:REPLICA IDENTITY 的 DEFAULT 記錄主鍵欄位的舊值;USING INDEX 記錄指定索引欄位的舊值,該索引「must be unique, not partial, not deferrable, and include only columns marked NOT NULL」。https://www.postgresql.org/docs/16/sql-altertable.html (查證日 2026-09-24) ↩
- Oracle 官方文件,Database-Level Supplemental Logging:無主鍵但有一個以上不可為空的唯一索引鍵時,會挑其中一個作為識別該列的依據;兩者皆無時,除 LONG 與 LOB 外的所有欄位都會被補充記錄。https://docs.oracle.com/database/121/SUTIL/GUID-D2DDD67C-E1CC-45A6-A2A7-198E4C142FA3.htm (查證日 2026-09-19) ↩
- HCL Informix 文件,CDC 記錄格式:
CDC_REC_UPDAFT的記錄專屬標頭包含序號、交易 ID、使用者資料(即cdc_startcapture()傳入的表識別)與保留旗標四個欄位。https://help.hcl-software.com/onedb/2.0.1/cdc/ids_cdc_040.html (查證日 2026-09-19) ↩ - PostgreSQL 官方文件,Table Basics:「SQL does not assign unique identifiers to rows, so it is possible to have several completely identical rows in a table.」https://www.postgresql.org/docs/current/ddl-basics.html (查證日 2026-09-24) ↩
- Debezium 官方文件,Tutorial:「Debezium is built on top of Apache Kafka and provides a set of Kafka Connect compatible connectors. Each of the connectors works with a specific database management system (DBMS).」並以 row-level changes、each change event to a Kafka topic 描述其輸出。https://debezium.io/documentation/reference/stable/kc-tutorial.html (查證日 2026-09-28) ↩
- 本機實測(2026-09-25)。環境:來源端 PostgreSQL 16.15(Debezium 官方 postgres 映像),目標端 PostgreSQL 16.14;Debezium 3.6.3.Final(PostgreSQL connector 與 JDBC sink connector,JDBC 驅動 PostgreSQL 42.7.13),Kafka 3.9.1、Kafka Connect 4.3.0。目標端寫入設定 insert.mode=upsert、primary.key.mode=record_key,其餘維持預設。情境:會員表把身分證號 A123456789 更正成 A123456780,並刪除一列;比較代理鍵當主鍵、業務值當主鍵、NOT NULL 唯一鍵(預設,以及補上 REPLICA IDENTITY USING INDEX)、允許 NULL 的唯一鍵,每一種各接「處理刪除」與「不處理刪除」兩種寫入設定。解碼外掛 decoderbufs(Debezium 預設)與 pgoutput 都測過,補上 REPLICA IDENTITY 後兩者結果相同;表上有多個唯一索引的情況未測。沒有主鍵時,Debezium 會拿表上第一個唯一索引當事件的鍵,不檢查欄位是否允許 NULL(原始碼 JdbcConnection.java 的 readPrimaryKeyOrUniqueIndexNames)。同一組情境在 Debezium 3.4.3.Final 結果相同。實測只用 PostgreSQL;Informix 的 Debezium connector 未實測。 ↩
- Debezium 官方文件,JDBC sink connector:delete.enabled 預設為 false;「By default, when the connector consumes DELETE or tombstone events, it does not delete the corresponding row in the sink database.」https://debezium.io/documentation/reference/stable/connectors/jdbc.html (查證日 2026-09-24) ↩
- Debezium 官方文件,PostgreSQL connector:「When a key changes, Debezium outputs three events: a DELETE event and a tombstone event with the old key for the row, followed by an event with the new key for the row.」REPLICA IDENTITY 維持預設時,沒有主鍵的表:「If a table does not have a primary key, the connector does not emit UPDATE or DELETE events for that table.」https://debezium.io/documentation/reference/stable/connectors/postgresql.html (查證日 2026-09-24) ↩
- PostgreSQL 官方文件,Publication:「If a table without a replica identity is added to a publication that replicates UPDATE or DELETE operations then subsequent UPDATE or DELETE operations will cause an error on the publisher.」Debezium 使用 pgoutput 時會自動建立 publication。https://www.postgresql.org/docs/16/logical-replication-publication.html (查證日 2026-09-25,本機實測相符) ↩
- Debezium 官方文件,PostgreSQL connector,Incremental snapshots:「Debezium captures each table in phases, in a series of configurable chunks.」「You can run incremental snapshots in parallel with streamed data capture, instead of postponing streaming until the snapshot completes.」以 execute-snapshot 訊號觸發。https://debezium.io/documentation/reference/stable/connectors/postgresql.html (查證日 2026-09-28) ↩
- E. F. Codd,〈Extending the Database Relational Model to Capture More Meaning〉, ACM TODS 4(4), 1979, §4, pp. 409–410:使用者控制的鍵「must therefore be subject to change by them」(例:兩家公司合併後員工編號被改)。 ↩
延伸閱讀
如果你也走在自己的路上,歡迎訂閱《小穗步電子報》——我會把每一次的覺察與練習,寫成信寄給你。→ 訂閱小穗步電子報